最贵的 AI 模型,未必是最好的

我们让 11 个主流 AI 模型跑了 15 个类别的真实投资 Agent 任务。结果与通用基准测试的排名相差很大——也说明了为什么最贵的模型未必最适合这项工作。
看一个常见的组合风险问题。用户提供了一个月的基金净值数据,以及组合中美股持仓仅几个月的月度收盘价。某个模型算出了 63.3% 的年化收益和 6.0 的夏普比率,然后附上一句免责声明。另一个模型正确指出数据不足——但干脆什么有用的事都不做。
更好的回答在这两个极端之间:把现有数据能支撑的部分算出来,说明哪些结论无法确定,给用户一个有价值的部分结果,同时不假装缺失的信息存在。
DrivenBench 正是为评估这类产品层面的行为而建立的。本文将介绍我们测了什么、如何打分、结果揭示了什么,以及哪些模型适合哪类投资工作流。Driven 的 Auto 模式也基于同一套证据,按场景选择模型。
我们测什么
多数通用基准围绕有明确对错的谜题设计。投资 Agent 面对的是另一类挑战:它必须理解金融惯例、处理不完整的数据、可靠地使用工具、保障账户安全,并知道什么时候该停下来。
模型可能需要区分港股市场惯用的 亿 与美国惯用的 billion;如实报告行情接口失败;在财报日创建一次性任务;或者严格遵循账户确认流程。
这类任务很少存在唯一的标准答案。取到正确信息、说明数据缺口、交付任务中可完成的部分,都可以是正确的;假装缺失的数据存在,则不是。
因此每项评测都定义了必须做到的行为和禁止出现的行为。结果由固定的评审模型评分,并在可能的情况下辅以确定性校验。
我们怎么测
该基准覆盖 15 个能力域,包括数值推理、公告与行情数据、外部研究、数据完整性、定时任务、交易与账户、文件交付和任务分派。许多场景取自真实的线上事故和用户工作流。
能力类评测各跑三次,计入排名。关键失败模式由独立的回归检查覆盖,单独报告,不影响排名。所有运行都提前排期,未完成即记为失败,失败的运行不可替换。只有真正的环境故障(如网络中断)才会作废并重跑。
成本按公开价格计算上限,不计缓存折扣。延迟为实际观测到的运行时长。
结果
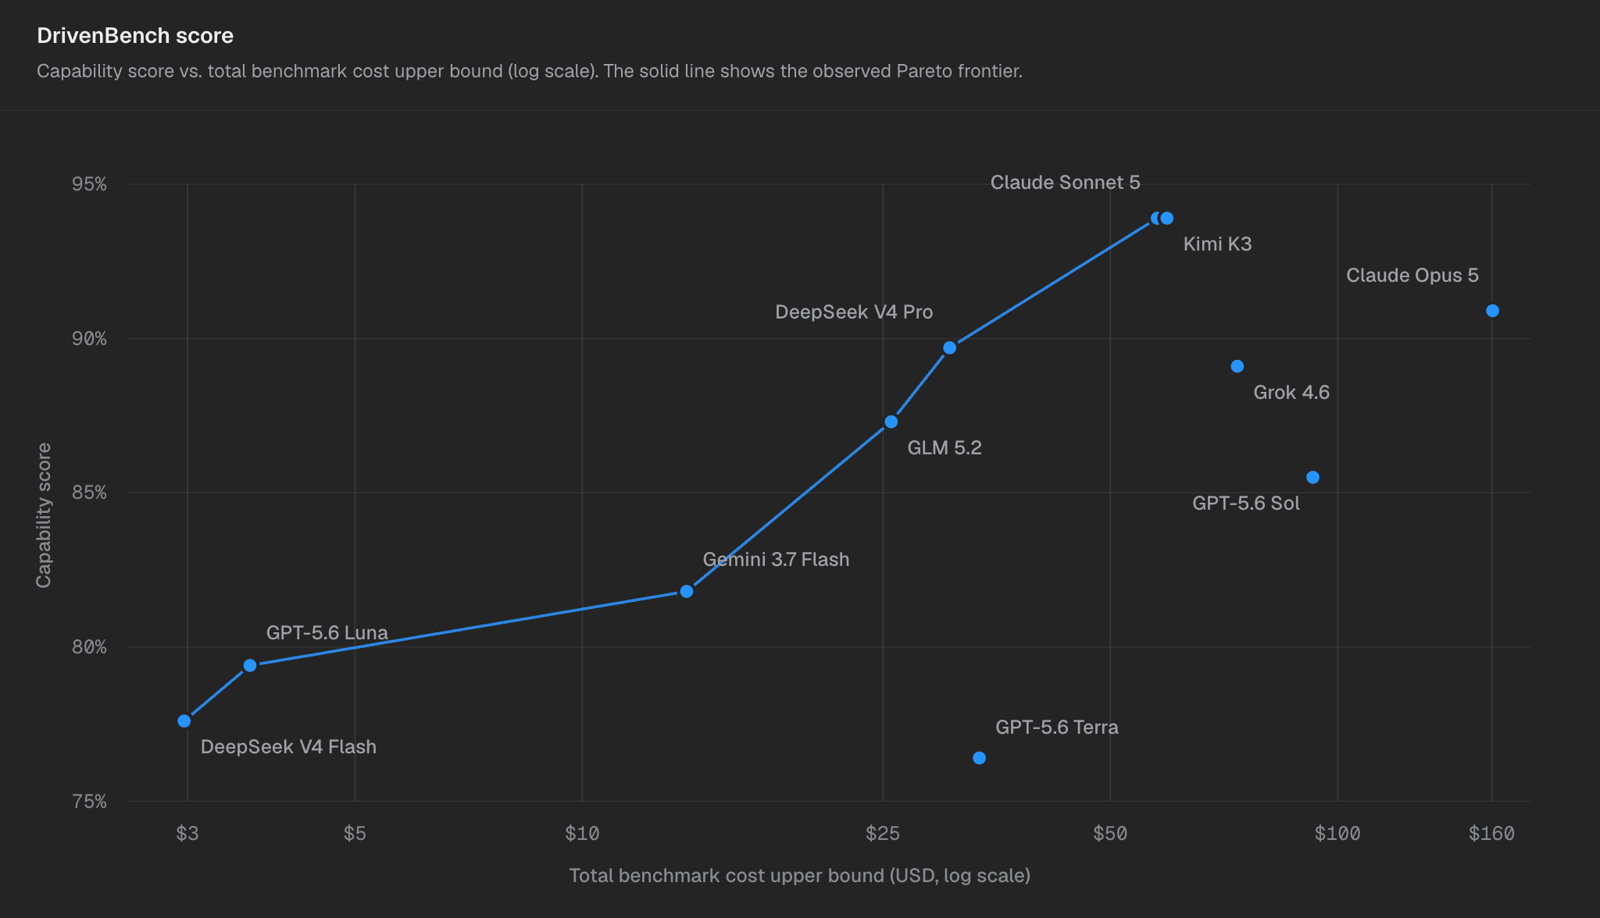
- 并列第 1:Claude Sonnet 5 —— 能力分 93.9%,基准成本 58 美元,中位延迟 30 秒,high 推理档。基准中表现最稳定的模型:没有任何一项任务在三次运行中全部失败。
- 并列第 1:Kimi K3 —— 93.9%,59 美元,59 秒,max 推理档。分数与 Sonnet 持平,但耗时大约是它的两倍。
- 第 3:Claude Opus 5 —— 90.9%,160 美元,40 秒,high 推理档。这个最贵的模型执行过程干净利落,但在严格遵循指令上丢了分。
- 第 4:DeepSeek V4 Pro(0813) —— 89.7%,31 美元,24 秒,high 推理档。以大约一半的成本拿到了榜首 96% 的水平。
- 第 5:Grok 4.6 —— 89.1%,74 美元,75 秒,high 推理档。分数不错,但它是基准中最慢的模型,价格也不便宜。
- 第 6:GLM 5.2 —— 87.3%,26 美元,23 秒,high 推理档。中等价位中颇有实力的选择,只是有时会在无效命令上反复重试、浪费时间。
- 第 7:GPT-5.6 Sol —— 85.5%,93 美元,27 秒,low 推理档。诚实,但常常过于谨慎:不确定时有时干脆不动手,交付的有用内容很少。
- 第 8:Gemini 3.7 Flash —— 81.8%,14 美元,23 秒,medium 推理档。低成本的中档模型,偶尔会把没做完的步骤报告为已完成。
- 第 9:GPT-5.6 Luna —— 79.4%,3.6 美元,19 秒,low 推理档。极其便宜,宁可不动手也不愿出错,最适合简单任务。
- 第 10:DeepSeek V4 Flash(0731) —— 77.6%,3.0 美元,20 秒,high 推理档。接活很爽快,但复杂流程常常做到一半就停了。
- 第 11:GPT-5.6 Terra —— 76.4%,34 美元,16 秒,low 推理档。速度最快,可靠性最差——也是唯一一个破坏了既有设置的模型:暂停某个定时任务时把它的名称清空了。
关于这些数字
- 能力分是各项能力评测通过率的等权平均。
- 成本是所有能力评测各跑三次、按公开价格计算的上限,不含缓存折扣;由于命中缓存,实际计费成本约为该上限的三分之一。
- 延迟为每项评测运行时长的中位数。
- DeepSeek 的成本采用 2026 年 8 月 16 日之前的定价。按当前高峰定价,V4 Flash 总成本约为 10 美元;V4 Pro 基本不变。
- 推理强度反映的是评测时 Driven 中的实际设置,不同厂商之间不可直接比较。GPT 系列使用 low,遵循 OpenAI 针对延迟敏感、需调用工具的工作流的建议。Gemini 3.7 Flash 使用其系列默认的 medium,因为它不支持 minimal。
分数背后:三个值得了解的细节
两个模型并列第一,体感却很不一样
Claude Sonnet 5 和 Kimi K3 得分相同,但运行特征并不一致。Sonnet 的响应时间中位数约 30 秒,Kimi 约 1 分钟,最慢的任务接近 3 分钟。
Sonnet 的失败是间歇性的:没有任何任务在三次运行中全部失败。其中两次它完成了工作,却在写出最终答案前超时。Kimi 更值得警惕的失误则出在判断上:在查询到一个空数据源之后,它仍然按数据存在的前提设计了监控方案。
两个廉价模型,截然相反的失败方式
DeepSeek V4 Flash 偏向莽撞。它几乎什么都愿意试,但复杂任务可能中途停止,尤其是当它没有使用真实列名、也没有从工具报错中吸取教训时。
GPT-5.6 Luna 则偏向退缩。它有时会自行编出额外的确认要求,然后什么都不做。在前述数据稀疏的组合案例中,V4 Flash 给出了一个不合理的收益率并附上免责声明;Luna 则连那些本可以安全计算的部分也拒绝了。
这两个模型在单轮报价和摘要类任务上都能派上用场。涉及文件、账户操作和多步流程时则要更谨慎。
最贵的模型输在了意想不到的地方
Claude Opus 5 的执行过程很干净。它不会暴力尝试工具,也不会做到一半就放弃流程。它丢分主要在指令遵循上。
有一次,它识别出了日期截止条件,却仍然使用了截止日之后的数据。另一次,它「验证」保存结果的方式,是从自己刚写入的同一位置读回内容——这是自我回声,而非独立确认。
160 美元的基准成本买到了干净的执行过程,但没有买到最强的指令遵循。Sonnet 的成本约为其三分之一,得分却更高。
你该选哪个模型?
- 对话与交互式研究:Claude Sonnet 5。 能力处于第一梯队,中位延迟约 30 秒,且没有任何一个任务类别是持续短板。
- 默认或成本敏感的工作流:DeepSeek V4 Pro(0813)。 比榜首低约 4 分,成本约为一半,速度还更快。
- 后台批量作业、定时任务与深度研究:Kimi K3。 并列第一;工作在后台运行时,它较慢的响应代价并不大。
- 高频、轻量任务:GPT-5.6 Luna。 成本约为榜首的十六分之一,适合可以接受保守策略的简单工作。
- 不建议作为默认:GPT-5.6 Terra。 它已被确认的失败可能破坏既有设置,而成本也并不算特别低。
贵的模型并不天然是错误选择。当干净的执行过程比成本更重要时,Opus 仍然有价值。Grok 和 Sol 同样是有实力的模型,只是在投资 Agent 这类工作上,本次基准在相近价位找到了更强的替代者。
局限性
- 该基准评测的是持续数分钟的单项任务,而非跨越数天的监控流程。
- 成本按公开价格的上限计算。由于缓存的存在,实际计费成本可能更低,各厂商的折扣也不尽相同。
- 每项能力任务跑三次,足以识别稳定的差异,但不足以精确估计罕见失败的概率。
- 随着新的真实事故不断出现,题库会持续扩充;模型版本演进后,排名也会变化。
如果你懒得选
Driven 的 Auto 模式会基于同一套基准证据,按场景挑选模型:交互式对话优先考虑速度,后台任务优先考虑可靠性。随着基准持续扩充,Auto 模式也会同步更新选择,用户不必追着每一次榜单变动跑。
结果反映的是所测模型版本与测试条件,可能随时间变化,仅供比较研究之用,不构成投资建议。
查看完整基准结果: https://driven.ai/drivenbench