Driven Skills:机构级投研能力,一句话就能调用

让一个通用 AI 助手「分析一下这只股票」,你会得到一段像是金融教科书写出来的推文:语气笃定、读起来顺畅,却在真正要紧的地方悄悄出错。模型把几种它自己都说不清名字的估值方法混在一起,靠训练时见得最多的说法作答,还会心安理得地编出一个目标价,附上一条根本不存在的引用。对好奇的投资者来说,这是个party trick;对真金白银在场上的人来说,这是风险。
Driven Skills Market 就是为填补这道鸿沟而生的。
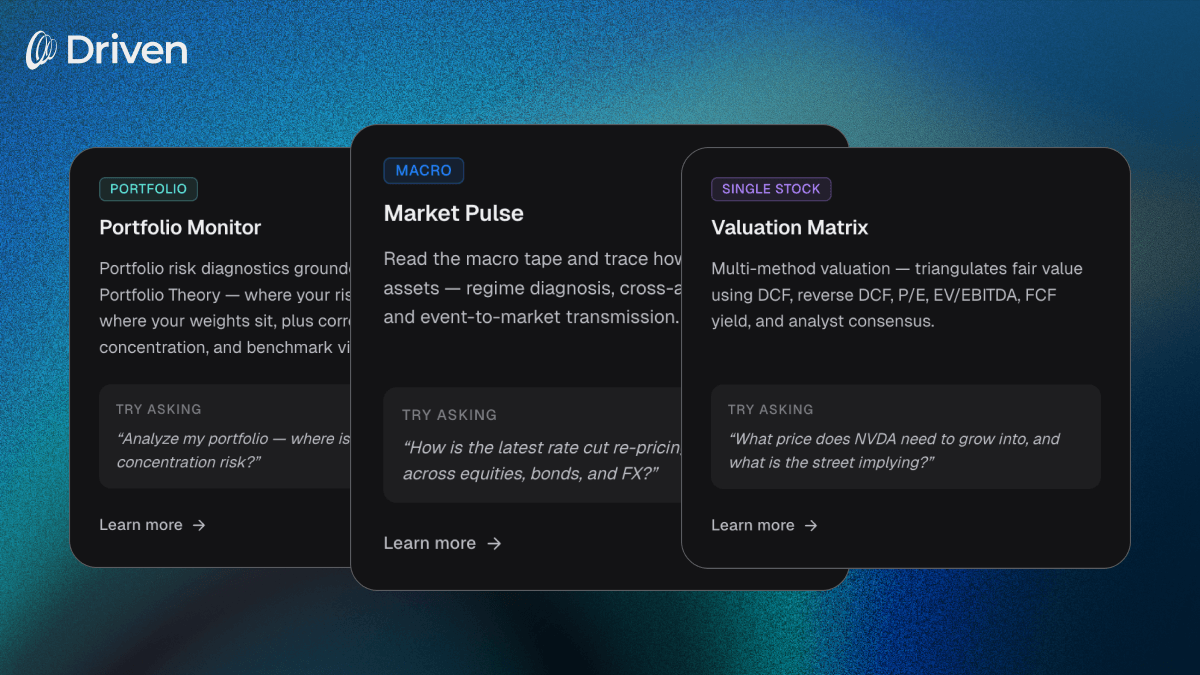
Driven 中的 Skill 并不是提示词模板,而是一套可复用、有名有姓的工作流,扎根于具体的投资框架——马科维茨的现代投资组合理论、Jegadeesh-Titman 的动量研究、达利欧的增长-通胀四象限、墨菲的跨市场分析、经典的现金流折现。每个 Skill 都规定了该问哪些问题、调取哪些数据源、如何对证据排序与加权、以及如何呈现结果。你的 Agent 随时可以调用其中任意一个。你只管在对话里提问,纪律交给 Skill。
今天我们发布第一批内置 Skill,覆盖投资者的完整工作流:研究、宏观、行业、选股、个股、聪明钱和投资组合。Market 会从这里持续生长。
每个 Skill 之下,是 Driven 的数据底座:230+ 个专业投资 API,覆盖全球行情、财务数据、交易所公告、分析师一致预期、持股披露、宏观序列和另类数据。框架再好,也好不过它脚下的数据——所以我们把这一层直接接到了专业数据源上,而不是去爬公开网页。
还有一个值得说明的设计选择:Skill 输出中的每一个数字——财务数据、价格、估值输入、因子得分、持仓——都直接来自这些数据 API,而不是来自模型。大模型负责编排流程、叙述发现,不负责编造数字。所以当你在 Driven 的输出里看到一个数据时,它的来源是可追溯的——而不是一条看起来很像样、一查就崩的引用。
本文将介绍这些内置 Skill 背后的设计原则。
每个 Skill 背后的设计原则
1. 扎根于有名有姓的框架,而不是感觉
Market 中的每个内置 Skill,都锚定在一套具体、可引用的方法论上。不是泛泛而谈的「最佳实践」,而是学术界和机构金融经典中真实存在的框架。
- 板块雷达 采用 Jegadeesh & Titman(1993)的方法为动量加权,并刻意跳过 1 个月动量——短期反转的相关文献(自 Jegadeesh 1990 起)表明,在短周期上反转效应会盖过动量信号。
- 组合监控 使用马科维茨(1952)的协方差数学做风险分解——它揭示的洞见是:如果一个占比 50% 的仓位与组合其余部分同向波动,它可能贡献了全组合 66% 的风险。
- 市场脉搏 把宏观环境归入达利欧增长-通胀四象限之一,沿 IMF/BIS 的五条传导渠道(利率、信贷、资产价格、汇率、预期)追踪事件的扩散路径,并采用墨菲的跨市场准则:当跨资产信号与盘面走势矛盾时,以跨资产的读数为准。
- 个股分析 用 Altman Z-Score 衡量破产风险、用 Piotroski F-Score 衡量价值质量,为企业健康度打分。
- 估值矩阵 在 DCF、前瞻市盈率、EV/EBITDA、自由现金流收益率和分析师一致预期之间做交叉验证——并配有一次 反向 DCF,从当前市值反推出隐含的自由现金流增速,让你在同一次分析中同时看到 合理价值 与 市场预期。
点名框架有两重意义。第一,它诚实:一个答案的价值不会超过它背后的方法,而方法理应被看见。第二,它可审计:当某个 Skill 的输出让你意外时,你可以把逻辑追溯到公开文献,自行判断这套方法是否适用。
2. 同业相对打分,而不是绝对阈值
15% 的毛利率在企业软件里很弱,在生鲜零售里堪称顶尖。25 倍市盈率对高成长的复利机器是便宜,对公用事业则是昂贵。绝对阈值——通用助手默认使用的那一套——一旦跨越行业边界就会制造大量误判。
Driven 的打分类 Skill 在同业集合内部排名:
- 选股器 把估值打分成 相对其他入围标的的百分位,而不是对照一个写死的市盈率红线。缺失的维度(例如银行没有有意义的 EV/EBITDA)会给中性分,权重顺势重新分配。
- 竞品分析 从营收增速(30%)、盈利能力(25%)、运营效率(20%)、利润率动量(15%)和研发(10%)五个维度为每个可比公司排名;当同业集合本身不靠研发竞争时(日常消费、公用事业),研发权重会重新分配。
- 板块雷达 在被扫描的 ETF 集合内部比较市盈率——科技对科技,必需消费对必需消费。
最终效果是:你得到的结论在 它所属的比较范围内 有意义,而不是一个看着很漂亮、直到你想起自己身处哪个行业才发现不对的数字。
3. 多源交叉验证,而不是单源检索
AI 把一个事实说错,代价并不在事实本身,而在于包裹这个事实的笃定语气。深度研究 正是围绕这种不对称设计的。
当你要求做一次深挖时,这个 Skill 会并行铺开:网页搜索(宽泛问题用语义检索,精确代码匹配用关键词)、SEC 文件、财报电话会纪要、分析师文章和结构化财务数据。然后它会做一件多数 AI 流程会跳过的事:交叉验证。只有单一来源支撑的说法会被标记为未经证实;事实(财报数字、价格数据)与观点(评级、评论)被分开;过期内容会按日期标注。最终输出是一份带引用、分析师风格的简报,以可下载文件的形式交付,让对话保持清爽,完整分析随时可以回头查阅。
这里的设计经验是:广度胜过任何单一的「最佳来源」。如果 AI 告诉你英伟达上季度数据中心收入增长了 112%,你会想知道这个数字是否同时出现在 10-Q、财报新闻稿和会议纪要里——还是只来自一篇可能写错了的文章。
4. 深度自适应,贴合分析师的真实工作方式
专业人士不会用同一套流程去回答「特斯拉昨天为什么跌了 8%」和「Meta 在当前价位估值是否合理」。前者需要在一分钟内看完情绪和技术面;后者需要基本面、估值、技术面和情绪的交叉验证。
个股分析 和 估值矩阵 无需切换模式即可自动伸缩:深度跟着提问走。问一个聚焦的问题,得到一个聚焦的回答;要一份完整分析,就得到四个维度加交叉核对。这正是资深分析师真实的时间分配方式——不是每天早上跑同一份报告,而是为眼前的问题挑对镜头。
5. 信念度过滤,而不是原始信号
内部人追踪 跟踪四条聪明钱披露流——Form 4 内部人交易、13F 机构持仓、STOCK 法案下的美国国会议员交易,以及主要股东变动。但这个 Skill 不会止步于「内部人 X 卖出 500 万美元」,它会做过滤:
- 集群买入(同一标的、同一时间窗内多位内部人同时出手)比单笔交易更有分量。
- 高管与董事之分——CEO 和 CFO 的买入比董事的交易更有权重。
- 相对于既有持仓的规模——持有 1,000 万美元的人买入 500 万,很有意义;持有 5 亿美元的人买入同样金额,只是噪音。
- 预设的 10b5-1 计划、税务驱动的减持、分散化操作 会被刻意降权,因为单看内部人 卖出 很少构成看空信号。
- 13F 有 45 天延迟——Skill 会明确提示这一点,让你知道所看到的持仓已经是旧数据。
「追踪器」和「信号」之间的差别就是全部。原始披露数据流会用海量动态把你淹没;设计良好的 Skill 会把真正的信念度浮出水面。
用起来是什么感觉
用 Skill 而不是自由对话,差别是这样的:
之前。 「亚马逊现在便宜吗?」→ 一段泛泛的文字,把市盈率和标普 500 均值比一比,对成长性含糊带过,再给一个留有余地的结论。
之后。 同一个问题,交给估值矩阵 Skill → 悲观 / 中性 / 乐观三档 DCF 情景下的合理价值区间、市盈率与行业区间对比、资本结构中性口径下的 EV/EBITDA、对标行业的自由现金流收益率、作为交叉验证的分析师一致预期,以及当前股价已经隐含的自由现金流增速。你拿到的是合理价值与现价之间的差距,以及市场隐含增速与分析师预期之间的落差——判断权仍然在你手里。
同一个问题,不同形状的答案,不同质量的决策。
投资者做给投资者用
Driven 出自一支自己也在这些市场里投真金白银的团队。设计上的偏好来自一个朴素的前提:认真的投资值得认真的工具,而 AI 在这个领域通用了太久。每个 Skill 都是我们反复自问的某个具体投资问题的答案——每个设计选择的背后,都是另一种做法曾在真实场景里让我们吃过亏。
这也是这些 Skill 公开点名各自方法论的原因。你应该清楚地知道正在运行的是哪套框架、它为什么这样加权、以及它的短板在哪里。没有魔法,没有黑箱。投资者信赖了数十年的框架,由你的 Agent 一致地执行。
来试试 Skills Market
Market 中的每个 Skill 今天都可以在 Driven 中使用——一句话就能调用。不妨从你最近问过通用 AI、却看着它答得磕磕绊绊的那个问题开始,把同样的问题交给对的 Skill,再比较两边的回答。
这是我们能给出的最有力的说明。